ПОЧЕМУ ЦИКЛ GREP ОБХОДИТСЯ AI-АГЕНТУ ДОРОГО: КАК CODEGRAPH МЕНЯЕТ ПОИСК ПО РЕПОЗИТОРИЮ
Кодовых AI-агентов внедряют, чтобы ускорить разработку и сократить её стоимость. Но значительная часть времени и контекста модели может уходить не на решение задачи, а на поиск нужных файлов и восстановление связей между ними. Для бизнеса это означает дополнительные расходы на токены, более длительное выполнение задач и время разработчиков на ожидание и проверку результата. CodeGraph помогает сократить эти издержки: он сразу предоставляет агенту структурно связанный контекст, уменьшает количество лишних поисков и чтений файлов и позволяет быстрее перейти непосредственно к реализации.
Автор:
Дмитрий Васильев
Категория:
Статьи
Дата публикации:
Введение
Представим типичную задачу: нужно изменить сигнатуру метода регистрации HTTP-маршрута и понять, какие части проекта затронет изменение.
Разработчик, знакомый с кодовой базой, примерно представляет, где находятся точка входа, обёртки и тесты. AI-агент начинает почти с нуля. Сначала он ищет имя метода, получает десятки совпадений, открывает несколько файлов, замечает новые функции и запускает следующий поиск. Затем отдельно изучает декораторы, импорты, наследников и тесты.
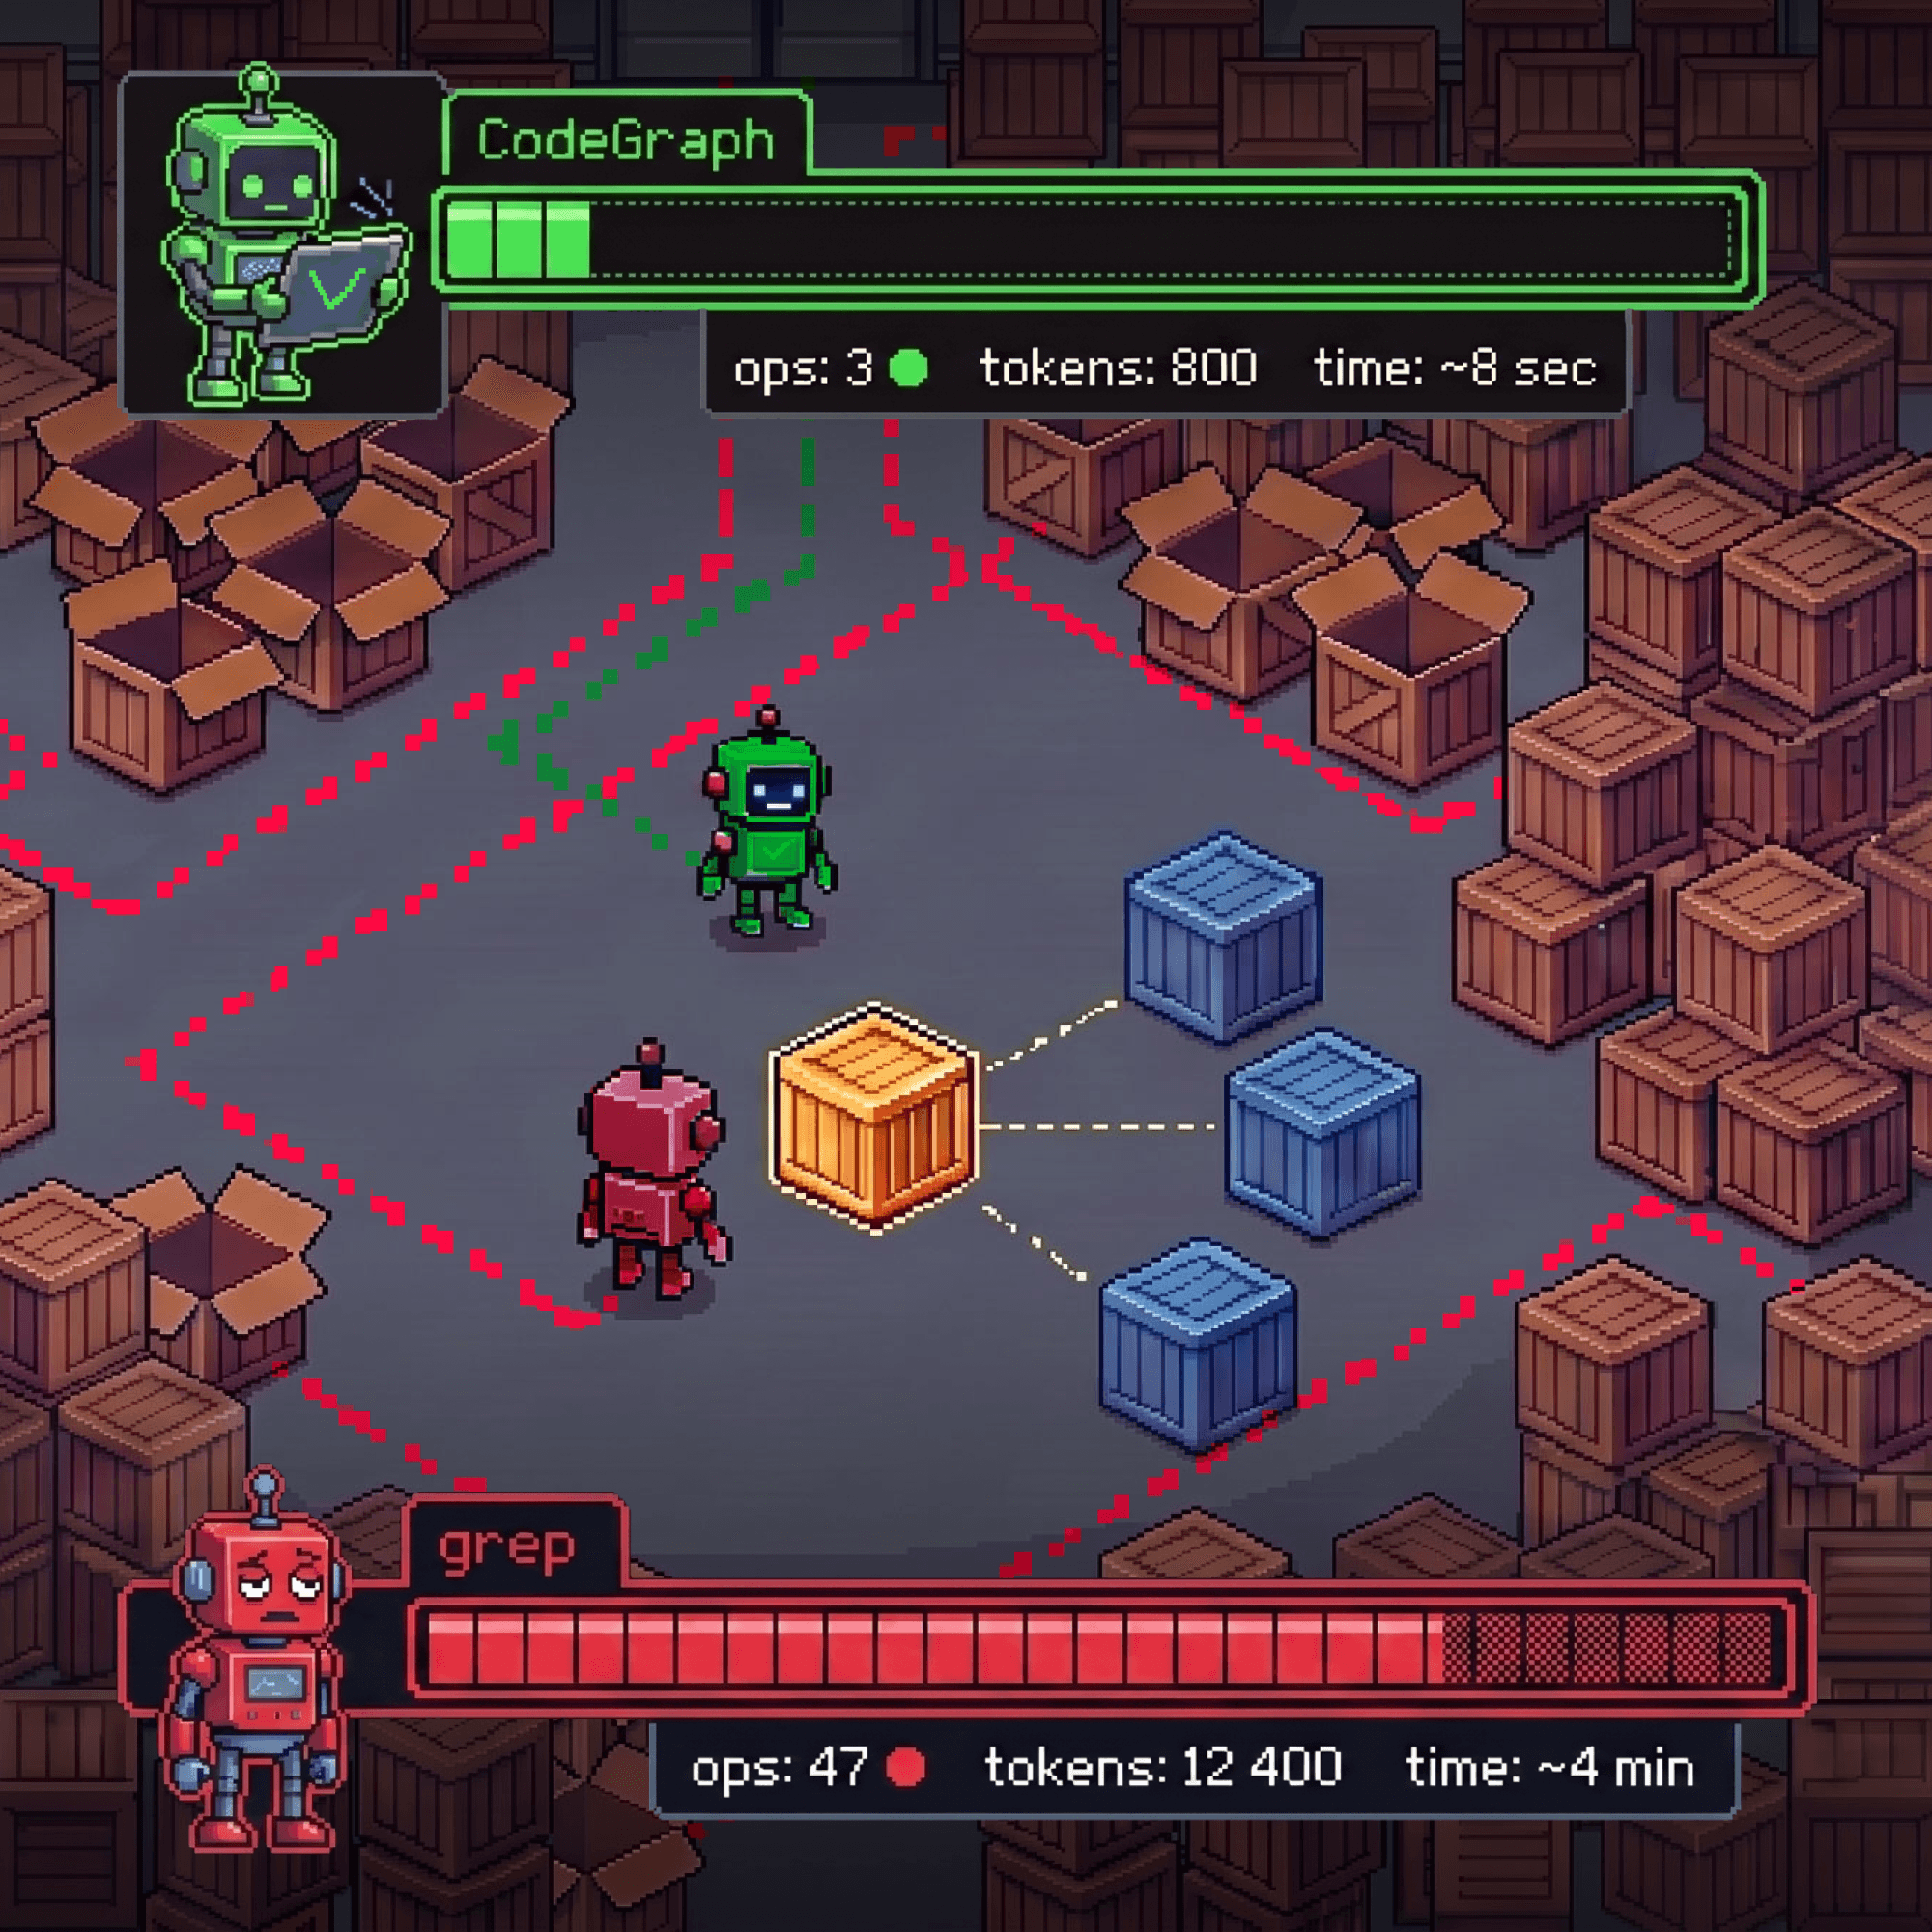
Сам по себе grep или rg почти ничего не стоит: это быстрый и прозрачный способ найти строку. Дорого обходится итерационный цикл «поиск → чтение файла → новое имя → новый поиск → ещё один файл». Каждая поисковая выдача и каждый открытый фрагмент попадают в контекст модели либо провоцируют очередной вызов инструмента. Если совпадения нерелевантны, агент тратит токены не только на их чтение, но и на то, чтобы отсеять их и выбрать следующий шаг.
CodeGraph предлагает изменить начальный этап исследования. Инструмент заранее индексирует проект как граф программных сущностей: функций, методов, классов, файлов, маршрутов и связей между ними. Вместо плоского списка строк агент может сначала запросить небольшой подграф вокруг нужного символа, а уже затем проверить ключевые места обычным поиском и чтением исходников.
Это не гарантированная экономия токенов и не замена grep. Граф меняет не размер файлов, а порядок получения контекста: сначала структурно связанные кандидаты, затем подтверждающие фрагменты.

Без структурного индекса агент расширяет контекст итерациями; CodeGraph позволяет начать со связанного набора кандидатов, но не отменяет проверку исходников и тестов

Все команды и меняющиеся характеристики в статье проверены 2 августа 2026 года на CodeGraph v1.5.0, выпущенном 21 июля 2026 года.
Для поиска расхождений отдельно проверен main на commit 49c11fc от 1 августа. Эти два состояния ниже не смешиваются.
Текстовый, векторный и графовый поиск решают разные задачи
Поиск по коду часто сводят к выбору между «обычным поиском» и «AI-поиском», хотя на практике полезны как минимум три разных подхода.
|
Подход |
На какой вопрос отвечает |
Где особенно полезен |
Типичный источник ошибок |
|---|---|---|---|
|
Текстовый поиск |
Где встречается эта строка? |
Точные имена, литералы, ключи конфигурации |
Не различает роли одноимённых символов и не показывает отношения между ними |
|
Векторный поиск |
Где говорится о похожем понятии? |
Документация, комментарии, разная терминология |
Смысловая близость не означает вызов или зависимость |
|
Граф кода |
Какие программные сущности связаны? |
Цепочки вызовов, импорты, реализации интерфейсов, оценка области изменений |
Статический анализ может пропустить динамические связи или построить ложное ребро |

Три способа поиска отвечают на разные вопросы и дополняют друг друга
CodeGraph относится к третьей категории. Его не стоит называть векторной базой или поиском по embeddings. В v1.5.0 лексический поиск выполняется через SQLite FTS5, после чего инструмент обходит структурные связи и ранжирует результаты запроса. Ценность появляется не из близости векторов, а из синтаксического дерева, разрешённых символов и типизированных рёбер графа.
Подходы не исключают друг друга. Текстовый поиск остаётся лучшим способом проверить точное имя или конфигурационную строку. Векторный retrieval помогает найти код, описывающий одну идею разными словами. Граф даёт более сильную начальную гипотезу, когда вопрос звучит как «кто вызывает этот метод?» или «что может сломаться после изменения интерфейса?».
Headroom сжимает уже выбранные сообщения и результаты инструментов перед передачей модели, а CodeGraph меняет сам этап отбора кода, стараясь раньше выбрать структурно связанные фрагменты. Эти подходы дополняют друг друга и не являются прямыми конкурентами.
Как из файлов получается граф
Индексирование проходит в несколько этапов.
Сначала CodeGraph выбирает исходники. По умолчанию он не индексирует пути из .gitignore, каталоги зависимостей, сборки и кэша, а также файлы размером больше 1 МиБ. Это уменьшает шум от node_modules, dist, виртуальных окружений и сгенерированных бандлов. Для уже отслеживаемых Git-файлов одного .gitignore недостаточно: исключение задаётся в поле codegraph.json.exclude.
Затем код разбирается с помощью tree-sitter — парсера, который строит синтаксическое дерево, не исполняя программу. В релизе 1.5.0 двадцать внутренних языковых идентификаторов получили быстрый путь через нативное Rust-ядро; если подходящего бинарника нет или конкретный файл содержит синтаксические ошибки, используется WASM fallback. README группирует поддержку в 34 языковые и платформенные категории, но это не обещание одинаковой глубины анализа. Например, Objective-C прямо помечен как partial support.
Из синтаксического дерева извлекаются программные сущности. В релизной схеме определены 22 типа узлов и 12 типов рёбер. Среди узлов есть файлы, функции, методы, классы, интерфейсы, маршруты и компоненты. Вместе с ними сохраняются путь, диапазон строк, сигнатура, docstring и некоторые модификаторы.
Рёбра описывают отношения: contains, calls, imports, extends, implements, references, instantiates и другие. После первичного извлечения выполняются дополнительные проходы для разрешения межфайловых ссылок. Инструмент сопоставляет импорты, qualified names, получателей методов и некоторые характерные для фреймворков конструкции.
Часть связей непосредственно следует из синтаксиса, а часть строится эвристически. Отдельные правила используются для обратных вызовов, событий, связки «интерфейс → реализация», компонентов React и соглашений некоторых фреймворков. Для ряда синтезированных рёбер сохраняется признак эвристического происхождения, но он заполнен не у каждой связи.
В прикладной задаче подграф может связать HTTP-декоратор, метод регистрации маршрута, создаваемый объект route, обработчик и тестовые области. Такой набор полезнее плоского списка совпадений: в нём уже есть предположение о роли каждого символа. Но это именно предположение. CodeGraph не исполняет программу, не отслеживает полный поток данных между всеми функциями и не выполняет вывод типов на уровне компилятора.
Как агент получает более связный контекст
Основной инструмент, который CodeGraph публикует через MCP, в версии 1.5.0 называется codegraph_explore. MCP, или Model Context Protocol, — это стандарт, через который ассистент обнаруживает и вызывает внешние инструменты. codegraph_explore принимает короткий вопрос или набор имён и возвращает исходный код подходящих символов с номерами строк, сгруппированный по файлам, а также найденные пути вызовов и краткую оценку blast radius — области возможного влияния изменения.
Вместо запроса «в каких файлах встречается add_api_route?» агент может начать с более содержательных вопросов:
- где находится точка входа регистрации HTTP-маршрута;
- какие публичные обёртки ведут к выбранному методу;
- какие реализации интерфейса могут зависеть от изменения сигнатуры;
- как событие проходит от producer к handler;
- какие тестовые файлы структурно связаны с затрагиваемыми символами.
В задаче на оценку последствий изменения агент сначала получает несколько кандидатов: публичный метод, внутреннюю реализацию, декораторную обёртку и связанные тестовые модули. Затем он открывает только ключевые участки и подтверждает связи точным поиском.
codegraph_explore уже возвращает дословные фрагменты исходников и потому может заменить часть полных чтений файлов. Однако его результат следует воспринимать как ранжированный набор кандидатов: критические связи необходимо подтверждать точным поиском, чтением исходников и тестами. Даже внешне цельный ответ не гарантирует, что граф нашёл все пути.
Индекс: построение, свежесть и приватность
Для воспроизводимости зафиксируем релиз в команде установки:
npm i -g @colbymchenry/codegraph@1.5.0

# Настроить обнаруженные кодовые ассистенты
codegraph install --target=auto --location=global --yes

cd /path/to/repository
codegraph init
codegraph status
init создаёт .codegraph/ и сразу строит первый полный индекс. Он хранится в .codegraph/codegraph.db: это локальная SQLite-база с FTS5. CodeGraph запрашивает WAL-режим, но на неподходящей сетевой или виртуальной файловой системе SQLite может выбрать другой journal mode, поэтому фактическое значение лучше смотреть в codegraph status.
Для последующих изменений есть два механизма codegraph sync обновляет изменившиеся файлы инкрементально. MCP-сервер дополнительно следит за изменениями файлов и после небольшой задержки обновляет индекс. При подключении он также сверяет индекс с текущим состоянием проекта. Это дешевле полной переиндексации после каждой правки, но не гарантирует абсолютную актуальность графа: обновление может ещё не завершиться, индекс мог быть построен старой версией движка извлечения и потребовать полного перестроения, а сверка большого проекта — занять заметное время.
Перед ответственным анализом разумная проверка выглядит так:
codegraph status
codegraph sync
Для полного перестроения используется codegraph index. Флаг --force не «усиливает» переиндексацию: в v1.5.0 он обходит защиту от случайного индексирования домашнего, корневого или слишком широкого каталога.
Индекс стоит считать воспроизводимым локальным артефактом, а не частью исходного репозитория. Создаваемый внутри .codegraph файл .gitignore скрывает содержимое каталога от Git. В новом окружении базу обычно безопаснее построить заново, особенно если прежний индекс использовался другим процессом или его создание не завершилось.
С приватностью важны две разные границы. Индексация и структурный поиск выполняются локально, а согласно политике телеметрии v1.5.0, CodeGraph не включает в свою телеметрию исходники, пути, имена репозиториев, символов и запросы. При этом телеметрия использования может быть включена, а MCP-сервер периодически проверяет наличие новой версии. Обе сетевые активности отключает:
export DO_NOT_TRACK=1
Переменную нужно задать до запуска кодового ассистента или в окружении MCP-сервера, после чего перезапустить клиент: уже работающий процесс не получит новое значение автоматически.
Но из этого не следует, что код вообще не покидает компьютер. codegraph_explore передаёт дословные фрагменты кодовому ассистенту. Если тот работает с облачной моделью, дальнейшая отправка определяется политикой клиента и модельного провайдера. Локальность CodeGraph не заменяет проверку настроек приватности самого ассистента.
Подключение к разным кодовым ассистентам
CodeGraph не привязан к одному агенту. Базовая интеграция — локальный MCP-сервер поверх STDIO:
|
Параметр |
Значение |
|---|---|
|
Transport |
STDIO |
|
Command |
codegraph |
|
Arguments |
serve, --mcp |

Индекс и структурные запросы CodeGraph выполняются локально; передача найденных фрагментов облачной модели зависит от выбранного ассистента и провайдера.
Кодовый ассистент запускает этот процесс в своей среде и получает опубликованные им инструменты. В v1.5.0 есть три способа подключения.
|
Сценарий |
Что делать |
Ограничение |
|---|---|---|
|
Один из штатных targets |
Использовать codegraph install |
Installer знает только восемь заранее описанных клиентов |
|
Другой локальный STDIO MCP-клиент |
Зарегистрировать command и args в его формате |
Файлы конфигурации и способы проверки различаются |
|
Агент без MCP, но с shell-доступом |
Вызывать codegraph explore "как работает авторизация" |
Инструкцию нужно отдельно сообщить агенту |
Штатный installer v1.5.0 поддерживает Claude Code, Cursor, Codex CLI, opencode, Hermes Agent, Gemini CLI, Antigravity IDE и Kiro. --target=auto выбирает обнаруженные клиенты, однако если не найден ни один, релиз откатывается к конфигурации Claude Code. Поэтому после неинтерактивного запуска стоит проверить, какие файлы изменились. Для нескольких известных клиентов targets можно указать явно:
codegraph install \
  --target=claude,cursor,gemini,opencode \
  --location=global \
  --yes

# Показать конфигурацию, ничего не записывая
codegraph install --print-config cursor
Installer предпочтительнее слепого копирования одного JSON. Например, для Cursor он добавляет --path, потому что клиент может запустить MCP-процесс не из корня проекта. У других продуктов различаются ключи, область global/local и действия после записи.
Если клиент не входит в восемь штатных targets, это ещё не означает несовместимость. Ручное подключение локальных STDIO MCP-серверов поддерживают, например, VS Code/GitHub Copilot, Windsurf/Cascade, Cline, Roo Code, Zed и JetBrains AI Assistant. В каждом случае нужно перенести те же command и args в формат конкретного клиента. Если сервер запускается вне индексированного проекта, запросу понадобится projectPath либо явный --path в конфигурации.
После перезапуска клиента следует убедиться, что появился codegraph_explore. По умолчанию v1.5.0 публикует только этот агрегирующий инструмент. Ещё семь — node, search, callers, callees, impact, files и status — реализованы, но скрыты; их можно включить через CODEGRAPH_MCP_TOOLS. Для первого подключения и воспроизводимого сравнения разумнее оставить конфигурацию по умолчанию.
Наконец, «поддерживает MCP» не равно «может прочитать мой локальный индекс». У веб- или облачного агента бинарник, репозиторий и каталог .codegraph должны находиться в доступной ему рабочей среде.
Что известно об экономии токенов
Универсального числа нет.
В benchmark из README v1.5.0 автор сравнивает Claude Code, запущенный без интерактивного интерфейса с моделью Claude Opus 4.8, на семи проектах с открытым исходным кодом. Для каждой группы приведена медиана четырёх прогонов. Автор сообщает о сокращении числа вызовов инструментов на 89%, расхода токенов на 69% и стоимости на 60%; медианное число отдельных чтений файлов было нулевым во всех семи репозиториях. Среднее время выполнения уменьшилось на 20%, хотя на двух небольших репозиториях базовый сценарий завершился быстрее.
Это полезный сигнал, но не независимая универсальная оценка. Результат зависит от модели, системных инструкций, выбранных архитектурных вопросов, способа подсчёта cached tokens и того, насколько активно агенту велели предпочитать codegraph_explore обычному чтению.
Более ранняя авторская A/B-матрица для v0.9.4 показывает, насколько вывод чувствителен к условиям. На 37 парах CodeGraph сократил количество чтений файлов на 76% и общее число вызовов инструментов примерно на 41%, но суммарная стоимость оказалась немного выше: $15,4 против $13,8. Там был всего один прогон на группу, что автор прямо называет snapshot, а не устойчивой оценкой.
Поэтому корректный вопрос звучит не «какой процент экономит CodeGraph?», а «уменьшает ли он стоимость отбора контекста на нашем типе задач без ухудшения ответа?».
Как проверить эффект на своём проекте
Для воспроизводимого сравнения можно взять FastAPI 0.141.1 на commit 95f8322 и дать агенту задачу на оценку последствий изменения: предположить, что в APIRouter.add_api_route() появляется новый обязательный keyword-only, то есть только именованный параметр. Он должен передаваться через все публичные API регистрации HTTP-маршрута; агенту требуется найти затрагиваемые цепочки в основном коде и тестовые области.
Этот пример требует различить несколько видов связей:
- FastAPI.add_api_route() напрямую делегирует в self.router.add_api_route();
- FastAPI.api_route() возвращает декоратор, замыкание которого при применении вызывает self.router.add_api_route();
- FastAPI.get(), put(), post() и остальные HTTP-методы делегируют одноимённым методам APIRouter;
- HTTP-методы APIRouter вызывают APIRouter.api_route(), а возвращаемый им декоратор при применении вызывает self.add_api_route();
- FastAPI.include_router() делегирует в APIRouter.include_router(), но тот на этом commit не вызывает add_api_route() повторно: он сохраняет _IncludedRouter, а эффективный контекст позднее строится из уже существующего APIRoute.

Ground truth для A/B-эксперимента на FastAPI 0.141.1, commit 95f8322.
Это не визуализация результата CodeGraph: схема отдельно собрана по исходникам проекта.
Последний пункт — намеренная проверка точности. Ответ, который по аналогии со старыми версиями FastAPI уверенно называет include_router() прямым вызывающим методом, должен получить штраф, даже если он короче и потребовал меньше токенов.
В ground truth стоит включить как минимум tests/main.py, tests/test_application.py, tests/test_extra_routes.py и tests/test_router_include_context.py; для метаданных и пользовательских классов маршрутов — tests/test_include_router_defaults_overrides.py и tests/test_custom_route_class.py.
Эксперимент строится так:
- Фиксируются commit репозитория, CodeGraph v1.5.0, версия кодового ассистента, точный model slug, reasoning level, sandbox и доступ к сети.
- Группа A получает штатные файловые и поисковые инструменты без CodeGraph. Группа B получает те же инструменты плюс стандартный codegraph_explore с заранее построенным индексом.
- Каждый прогон начинается с чистого контекста. Порядок чередуется AB/BA, минимум по пять прогонов на группу.
- Ground truth заранее собирается независимо: ручным разбором, точным текстовым или AST-поиском, чтением существующих тестов и при необходимости отдельным запуском целевых тестов.
- Для каждого прогона сохраняются полная история действий и статистика использования инструментов. Ответы оцениваются по заранее подготовленным критериям без указания группы, к которой относится результат.
Сначала сравниваются корректность и полнота цепочек в основном коде, правильная классификация include_router(), отсутствие выдуманных зависимостей и проверяемость ссылок на файлы и символы. Только затем считаются вызовы инструментов, открытые файлы, объём возвращённого кода, input/cached/output tokens — если клиент предоставляет эти значения раздельно, — wall time и стоимость.
Первичное индексирование нужно измерять отдельно: время, пиковые CPU/RAM и размер .codegraph. Его нельзя прятать, но и нельзя прибавлять к каждой последующей задаче, если команда использует один индекс много раз. Для результатов лучше публиковать все прогоны, медиану и межквартильный размах (IQR); при пяти повторах не стоит изображать статистическую значимость.
В этой статье формальный агентский A/B-тест не подменяется одним smoke-test. Поэтому авторские проценты выше остаются атрибутированными заявлениями проекта, а не нашим подтверждённым результатом.
Когда CodeGraph не даёт полной картины
Самый опасный результат — не явно сломанный граф, а правдоподобно полный ответ с пропущенной связью.
Статический анализ ограничен там, где поведение определяется во время выполнения: при рефлексии, внедрении зависимостей через конфигурацию, подмене методов, вычисляемых именах, использовании eval, нетипичных обратных вызовах, динамической диспетчеризации и сложных макросах. Соглашения фреймворков тоже не всегда выражены прямым вызовом. Эвристики помогают находить больше потенциальных связей, но одновременно увеличивают риск ложных совпадений.
Открытые на момент проверки issues показывают несколько характерных классов ошибок:
- #1496 — вызов через поле this связывается с одноимённым окружающим методом и создаёт self-edge;
- #1482 — alias через export const разрывает caller/impact traversal;
- #1473 — fuzzy-поиск может молча подставить другой символ в callers, callees или impact;
- #1449 — пользовательский отчёт о медленной или зависающей инициализации крупного монорепозитория.
Первые три случая затрагивают точность или полноту графа. Четвёртый напоминает, что предварительный индекс тоже имеет эксплуатационную стоимость. На небольшом проекте она может не окупиться, потому что нужный путь и так помещается в один-два файла. На монорепозитории важно отдельно измерить полную переиндексацию, инкрементальное обновление, размер базы и поведение параллельных запросов.
Есть и риск быстрого изменения самого инструмента. На момент проверки main уже содержал исправления, отсутствующие в v1.5.0, включая дополнительную защиту от устаревших диапазонов строк. Поэтому установленную версию, документацию и unreleased-код следует разделять: наличие фикса в основной ветке ещё не делает его свойством релиза.
Практическое правило получается простым:
- граф используется как навигатор и генератор гипотез;
- точный текстовый поиск проверяет имена, конфигурацию и возможные пропуски;
- чтение исходника подтверждает критические пути;
- тесты проверяют фактическое поведение.
Граф как навигатор, а не источник истины
CodeGraph не отменяет текстовый поиск, чтение исходников и тесты. Он меняет первый шаг исследования: вместо плоского списка совпадений агент получает небольшой набор символов, связанных вызовами, импортами и другими отношениями.
Такой подход полезен только при двух условиях: граф сохраняет достаточную полноту ответа и действительно сокращает число лишних поисков и чтений. На небольшом или сильно динамическом проекте стоимость индекса и риск пропущенных связей могут перевесить пользу. Поэтому CodeGraph разумно оценивать не по одному проценту из авторского benchmark, а по результатам воспроизводимого сравнения на конкретном репозитории и типичных для команды задачах.
Использованные источники
- Репозиторий CodeGraph, релиз v1.5.0 и зафиксированное состояние main на commit 49c11fc.
- README v1.5.0: языки, установка и авторский benchmark, схема SQLite/FTS5, типы узлов и рёбер, обход графа и MCP-инструменты.
- Политика телеметрии CodeGraph v1.5.0 и реестр штатных targets installer.
- Официальная документация MCP-клиентов: VS Code/GitHub Copilot, Windsurf, Cline, Roo Code, Zed и JetBrains AI Assistant.
- Авторская A/B-матрица CodeGraph v0.9.4 и FastAPI 0.141.1 на commit 95f8322, выбранный для методики эксперимента.
- Открытые issues CodeGraph: #1496, #1482, #1473 и #1449.