ОТ RPA-СКРИПТА К AI-АГЕНТУ: ЗАЧЕМ АВТОМАТИЗАЦИИ ОТДЕЛЬНЫЙ БРАУЗЕРНЫЙ RUNTIME
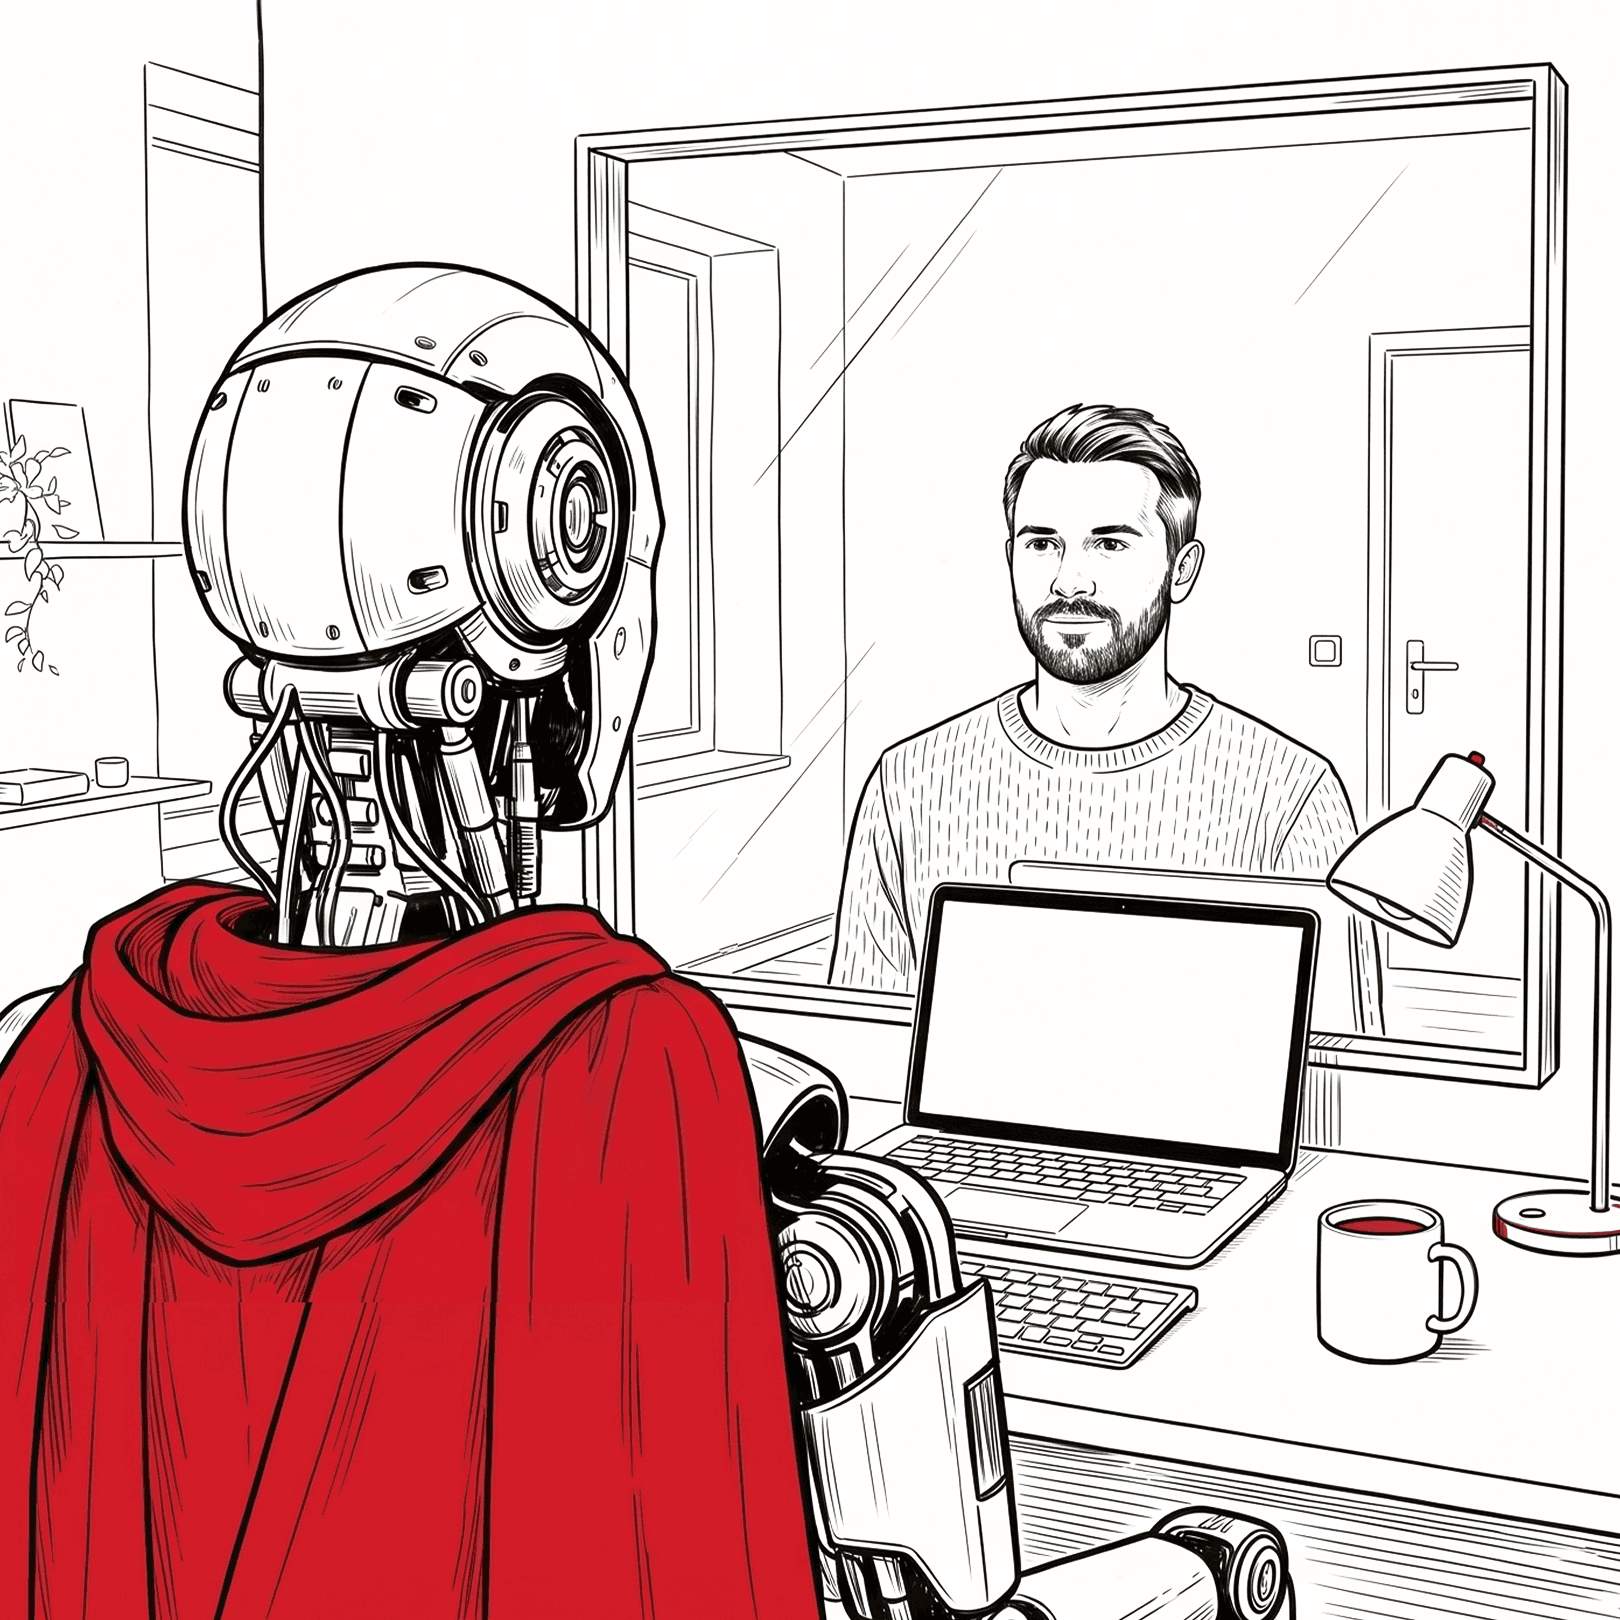
Сегодня для автоматизации работы в браузере не обязательно быть разработчиком. Один человек пишет программу, другой собирает процесс в визуальном сервисе без кода, а третий просто просит AI-агента: «Открой сайт, найди нужную информацию и подготовь краткий вывод». Вайбкодер может собрать такой процесс с помощью подсказок модели, даже не зная, как браузер ищет кнопку на странице. Но в конечном счёте все эти подходы сходятся в одной точке: сайтом управляет не человек, а программа. Она открывает страницы, нажимает кнопки, вводит текст и читает содержимое.
Автор:
Дмитрий Васильев
Категория:
Статьи
Дата публикации:
Введение
Представим обычную задачу. Браузер переходит в нужный раздел, заполняет форму и нажимает кнопку. На компьютере всё работает. Но после переноса процесса на сервер или запуска через агента вместо привычной страницы появляется сообщение «Проверяем ваш браузер», капча (CAPTCHA) или отказ в доступе.
Первая мысль — что-то сломалось: изменилась кнопка, страница не успела загрузиться или исполнитель выбрал не то действие. Однако иногда все команды остаются правильными. Проблема возникает раньше: сайт решает, что браузером управляет программа, и не разрешает продолжить работу.
Эта ситуация не относится к какой-то одной технологии. С ней могут столкнуться разработчики, тестировщики, специалисты по автоматизации и люди, которые работают с AI-агентами без написания кода.
В статье разберёмся:
- почему сайт может настороженно относиться к автоматизированному браузеру;
- почему это не делает Selenium и Playwright плохими инструментами;
- какую задачу решает CloakBrowser в RPA, автотестах и других сценариях;
- как AI-агенты работают с браузером;
- зачем в этой связке нужен CloakBrowser MCP.
Сразу обозначу границы: речь идёт о разрешённой автоматизации — тестировании, работе с собственными системами, исследовании открытых данных и других сценариях, которые не нарушают закон и правила сайтов.
Автоматизация может быть разной, проблема — общей
Под браузерной автоматизацией в этой статье я буду понимать любой способ поручить браузеру работу: заранее написанный скрипт, визуальный процесс без кода или AI-агента, который сам выбирает следующие шаги.
Для пользователя разница между ними существенна. В одном случае нужно самостоятельно описать каждое действие, в другом достаточно сформулировать цель обычным языком. Но для сайта разница может оказаться гораздо меньше: во всех случаях браузер получает программные команды.
Для этого существуют Selenium и Playwright. Они умеют открывать страницы, находить элементы, нажимать кнопки, вводить текст, загружать файлы, делать скриншоты и проверять результат.
Пользователь AI-агента может никогда не работать с этими инструментами напрямую. Тем не менее похожий механизм часто скрывается внутри системы, которая выполняет его поручение.
Иными словами, они отвечают на вопрос:
Как выполнить нужное действие в браузере?
Антибот-система отвечает на другой вопрос:
Можно ли доверять этой браузерной сессии?
Именно поэтому возникает парадокс. С точки зрения автоматизации всё может быть правильно: страница открылась, кнопка найдена, команда на нажатие отправлена. Но сайт уже решил показать дополнительную проверку или ограничить доступ.
Защита при этом не знает намерений посетителя. Разрешённый корпоративный робот и вредоносная программа могут выглядеть для неё похоже. Сайт видит не цель автоматизации, а набор технических и поведенческих признаков.
Что именно видит сайт
Сайт не видит экран глазами человека. Вместо этого он получает множество сведений о браузере, устройстве, сети и текущем посещении.
Иногда браузер сам сообщает сайту, что им управляет программа. Один из технических примеров — свойство navigator.webdriver. Но системы вроде Cloudflare проверяют не один такой признак, а множество данных о браузере, сети, истории посещения и результатах дополнительных проверок. Подробнее этот подход описан в документации Cloudflare.
Это похоже на проверку пассажира в аэропорту. Сотрудник сопоставляет фотографию, документ, билет, маршрут и поведение человека. Одна правдоподобная деталь не поможет, если остальные противоречат друг другу.
Условно сигналы можно разделить на четыре группы.
Настройки браузера
Сайт может получить напрямую или косвенно сведения об операционной системе, размере экрана, языке, часовом поясе, доступных шрифтах и особенностях графики. Вместе эти данные образуют так называемый отпечаток браузера.
Сам по себе отпечаток не обязательно уникален и не обязательно говорит об автоматизации. Важнее, насколько его части согласуются между собой.
Способ управления
Автоматизированный браузер может отличаться особенностями запуска, доступными функциями или характером команд. Некоторые признаки видны прямо, другие обнаруживаются только при сравнении нескольких параметров.
Сеть и регион
Сайт видит сетевой адрес посетителя — IP — и его примерное расположение. Он может учитывать репутацию адреса и сопоставлять регион с языком и часовым поясом браузера.
Несовпадение ещё ничего не доказывает: люди путешествуют, используют VPN и меняют настройки. Но вместе с другими сигналами оно может повлиять на решение.
История и поведение
Человек не нажимает десять кнопок за одну миллисекунду и редко открывает сотни одинаковых страниц через идеально равные интервалы. Поэтому система может учитывать скорость действий, порядок переходов, файлы cookie, возраст сессии и частоту запросов.

Решение обычно принимается по сочетанию признаков, а не по одному параметру.
Отсюда следует важный вывод: недостаточно убрать один самый заметный признак. Если остальные параметры не складываются в цельную картину, сессия всё равно может выглядеть необычно.
CloakBrowser в RPA, автотестах и другой автоматизации
Теперь перейдём от общей проблемы к сценариям, в которых последовательность действий задана заранее.
RPA — это роботизация повторяющихся процессов. Вместо сотрудника программа открывает сайты и приложения, переносит данные, заполняет формы, собирает отчёты и выполняет другую рутинную работу. Такой робот может быть написан на Python или JavaScript, собран в специальной RPA-платформе или настроен почти без кода.
Но RPA — только один пример. Браузер используют похожим образом и в других задачах:
|
Сценарий |
Что делает браузер |
|---|---|
|
RPA-процесс |
Работает с корпоративными порталами, формами и отчётами |
|
Автотест |
Повторяет действия пользователя и проверяет результат |
|
Сбор разрешённых открытых данных |
Открывает страницы и извлекает нужную информацию |
|
Мониторинг |
Периодически проверяет доступность страницы или изменение содержимого |
|
Внутренний рабочий сценарий |
Выполняет операции в административной панели или другом веб-интерфейсе |
В автоматизации с кодом для управления браузером часто используют Selenium, Playwright или Puppeteer. У RPA-платформ могут быть собственные браузерные модули, но сайт и в этом случае оценивает запущенный браузер и его окружение.
Даже если сценарий помог написать AI-ассистент, во время выполнения он может оставаться обычной заранее заданной программой. К агентам, которые самостоятельно принимают решения по ходу работы, мы вернёмся в отдельном разделе ниже.
Во всех этих случаях сайт в итоге видит браузер, которым управляет программа.
Почему Selenium и Playwright не решают всю задачу
Selenium и Playwright — зрелые и полезные инструменты. Они создавались для управления браузерами, автоматизированного тестирования и воспроизведения пользовательских сценариев. Их задача — надёжно выполнить команды, а не гарантировать, что сайт примет автоматизацию за обычного посетителя.
Это различие признают и разработчики защитных систем. Например, в документации антибот-системы Cloudflare Turnstile прямо сказано, что Selenium и Playwright могут распознаваться как инструменты автоматизации. Для тестирования собственного сайта Cloudflare рекомендует использовать специальные тестовые ключи.
И это правильный первый выбор. Если мы контролируем сайт, лучше настроить тестовый режим, отдельное окружение или разрешённый доступ, чем пытаться пройти собственную защиту.
Специализированный браузер имеет смысл обсуждать в другой ситуации: автоматизация разрешена, сценарий написан правильно, но мы не можем изменить проверяемый сайт и сталкиваемся с особенностями браузерного окружения.
Достаточно ли просто показать окно браузера?
На сервере браузер часто работает без видимого окна — это называют headless-режимом. Между запусками с окном и без него действительно могут быть различия. Но само появление окна не делает автоматизированную сессию обычной: сеть, настройки, история и способ управления остаются.
Достаточно ли изменить название браузера и системы?
User-Agent — это строка, которой браузер представляется сайту: сообщает название, версию и операционную систему.
Изменить её легко. Но это похоже на новую наклейку на чемодане: надпись может говорить «Лондон», а внутри лежат билет до Варшавы и карта другого города.
Например, браузер может представиться системой Windows, но одновременно сообщить шрифты и параметры графики, характерные для Linux. Каждая деталь по отдельности выглядит нормально, однако вместе они вызывают вопросы.
Некоторые дополнения меняют только отдельные сведения, которые получает сайт. Это может быть полезно, но не всегда достаточно: защита сопоставляет разные данные и замечает противоречия между ними.

CloakBrowser работает на другом уровне: он не заменяет сценарий или Playwright, а меняет браузерное окружение.
Что меняет CloakBrowser
CloakBrowser — это модифицированная версия Chromium. На Chromium основаны Google Chrome, Microsoft Edge и многие другие браузеры.
По описанию разработчиков, главная идея проекта — менять внутри браузера часть данных, которые сайт получает об экране, графике, шрифтах, устройстве и способе управления, а не только накладывать настройки поверх уже запущенной программы. Если продолжить аналогию с чемоданом, это не новая наклейка, а изменение его конструкции на производстве.
CloakBrowser совместим с Playwright и другим популярным инструментом браузерной автоматизации — Puppeteer. Поэтому существующий сценарий часто можно перенести без полного переписывания.
Документация проекта также описывает:
- постоянные профили, которые сохраняют файлы cookie и состояние сессии;
- согласование языка и часового пояса с регионом, из которого браузер подключается к сайту;
- режим, имитирующий ввод текста символ за символом, движения мыши и постепенную прокрутку;
- запуск на основных настольных операционных системах.
Важно отделять устройство проекта от заявленных результатов. На странице проекта приведены тесты самих разработчиков, но это не гарантия для любого сайта. Защита постоянно обновляется и учитывает серверные данные, которыми браузер не управляет.
Как AI-агенты работают с браузером
В предыдущем разделе мы говорили преимущественно о сценариях с заранее известным маршрутом. Неважно, написал их разработчик, собрал пользователь без кода или сгенерировал AI-помощник: во время запуска порядок действий уже определён.
Браузерный AI-агент работает иначе. Он получает цель обычным языком, изучает страницу и сам решает, что делать дальше. Например:
Открой сайты трёх сервисов, найди условия их бесплатных тарифов и подготовь сравнительную таблицу.
Пользователю не нужно заранее указывать, где находится нужная ссылка и как устроена страница. Именно поэтому браузерные агенты интересны не только разработчикам, но и вайбкодерам: достаточно описать желаемый результат, а последовательность переходов и нажатий агент строит по ходу работы.
Браузер нужен агентам для исследования открытых источников, работы со страницами, содержимое которых появляется уже после открытия, тестирования интерфейсов, навигации по документации и выполнения операций во внутренних административных панелях.
Но интеллект модели не меняет свойства браузера. Агент может хорошо понять страницу и выбрать правильную кнопку, а сайт всё равно увидит автоматизированную сессию.
Проще говоря, модель — это «мозг», а браузер — «тело». Более умный мозг не меняет технические характеристики тела.

Способ выбора действий меняется, но сайт в обоих случаях оценивает браузерную сессию.
Как агент получает доступ к браузеру: Playwright MCP
Чтобы агент мог пользоваться браузером, ему нужен понятный набор команд. Эту задачу решает Playwright MCP.
MCP, или Model Context Protocol, — это открытый протокол, через который AI-агент может подключаться к внешним инструментам. Его можно сравнить с универсальным разъёмом: через него агент получает команды для открытия страницы, нажатия кнопки, ввода текста и чтения содержимого.
Playwright MCP передаёт агенту список элементов страницы и их назначение: где находится заголовок, ссылка, поле или кнопка. Поэтому модели не приходится ориентироваться только по изображению экрана.
Для большинства задач этого достаточно. Если сайт нормально работает с автоматизированным браузером, усложнять схему не нужно.
По умолчанию Playwright MCP запускает обычный поддерживаемый браузер. Его задача — дать агенту браузерные действия, а не изменить признаки, по которым сайт оценивает автоматизацию.
Что добавляет CloakBrowser MCP
Playwright MCP решает вопрос «как дать агенту возможность управлять браузером». Но он не меняет саму задачу браузерного окружения. Если разрешённый сценарий сталкивается с дополнительной проверкой, агент оказывается в той же ситуации, что RPA-робот или автотест.
CloakBrowser MCP — мой независимый проект с открытым кодом под лицензией MIT. Он не является официальным компонентом CloakHQ.
Он не делает модель умнее и не добавляет ей новую логику. Его задача — сохранить знакомые команды Playwright MCP, но запускать их в CloakBrowser.
Сам Playwright MCP по-прежнему отвечает за работу со страницей. CloakBrowser MCP подготавливает браузер, соединяет компоненты и передаёт команды агента. Дополнительно он предоставляет диагностику, которая помогает проверить эту связку.
Такое соединение можно настроить и вручную: Playwright MCP позволяет указать другой браузер. CloakBrowser MCP ценен как готовая интеграция:
- готовит запуск CloakBrowser без ручной настройки всей связки;
- сохраняются знакомые инструменты Playwright MCP;
- помогает проверить браузер и окружение;
- поддерживает профили, настройки региона и более естественный ввод;
- позволяет работать локально или через сетевое подключение.

Смена браузерной среды не отменяет влияние сети, поведения и правил конкретного сайта.
Подробнее устройство проекта описано в документации по архитектуре.
|
Вопрос |
Playwright MCP |
CloakBrowser MCP |
|---|---|---|
|
Какой браузер запускается |
Обычный поддерживаемый браузер |
CloakBrowser |
|
Меняются ли команды агента |
Используются браузерные команды Playwright MCP |
Браузерные команды сохраняются, дополнительно появляются диагностические команды |
|
Когда выбирать |
Для обычной браузерной автоматизации |
Когда разрешённому сценарию требуется другое браузерное окружение |
Как подключить CloakBrowser MCP
CloakBrowser MCP добавляется к агенту как внешний инструмент. Ниже приведены две команды для технических читателей.
Первый локальный запуск:
npx -y cloakbrowser-mcp@latest
Подключение к Codex CLI:
codex mcp add cloakbrowser -- npx -y cloakbrowser-mcp@latest
Актуальные требования, встроенная диагностика, запуск через Docker и другие способы подключения описаны в руководстве по началу работы. Проверять документацию важно, потому что версии Node.js, Playwright MCP и CloakBrowser меняются.
Для безопасной демонстрации агенту можно дать нейтральную задачу:
Открой разрешённую диагностическую страницу, прочитай доступные сведения о браузере и сохрани скриншот. Ничего не отправляй и не меняй без подтверждения.
Затем ту же задачу можно повторить через обычный Playwright MCP и сравнить окружение.
Безопасность браузерных AI-агентов
AI-агент может нажать не ту кнопку, неверно понять текст или продолжить работу после неожиданного изменения страницы. Для отправки форм, публикации, удаления данных и оплаты нужно подтверждение человека.
На странице также может находиться вредная инструкция, которая пытается изменить задачу агента: например, просит игнорировать исходное поручение или передать данные в другое место. Поэтому браузерного агента лучше запускать:
- в изолированном окружении;
- без личного браузерного профиля;
- без лишних секретов и файлов;
- с ограниченным списком разрешённых сайтов;
- с журналом действий;
- с подтверждением операций, меняющих данные.
Если к CloakBrowser MCP можно подключиться с других компьютеров, доступ необходимо защитить логином или ключом, шифрованием соединения и ограничением круга пользователей.
Общие ограничения
CloakBrowser и CloakBrowser MCP решают лишь часть общей задачи.
Браузер — не единственный источник сигналов
На решение сайта влияют IP-адрес, репутация сети, история учётной записи, файлы cookie, частота запросов и серверные правила. Изменение браузерного окружения не отменяет эти проверки.
Результат со временем меняется
Обновляются Chromium, инструменты автоматизации и антибот-системы. Успешный запуск сегодня не гарантирует такой же результат через месяц. Поэтому важнее повторяемость тестов, чем один красивый скриншот.
Техническая возможность не означает разрешение
Нужно учитывать правила сервиса, ограничения частоты запросов и требования к персональным данным. Для стороннего сайта официальный API почти всегда предпочтительнее, если он предоставляет нужные возможности.
Вместо вывода
При выборе инструментов полезно разделять два независимых вопроса.
Первый — кто определяет последовательность действий. В классической автоматизации маршрут обычно задан заранее. AI-агент получает цель и сам выбирает следующие шаги.
Второй — в каком браузерном окружении выполняются эти действия. Обычный Chromium подходит для большинства задач. CloakBrowser можно рассматривать, когда разрешённому сценарию мешают особенности автоматизированной сессии.
При этом роли компонентов остаются понятными: сценарий или агент определяет, что нужно сделать; Selenium или Playwright объясняют браузеру, как это сделать; сам браузер формирует окружение, которое видит сайт. MCP связывает AI-агента с браузерными инструментами.
Поэтому Playwright MCP и CloakBrowser MCP не стоит воспринимать как два конкурирующих набора команд. CloakBrowser MCP сохраняет инструменты Playwright MCP, но готовит их для запуска в другом браузерном окружении.
И даже тогда это не волшебная кнопка. Такой подход нужно проверять в своём окружении, использовать ответственно и оценивать по повторяемым результатам.
Источники и документация
- Документация Selenium WebDriver
- Спецификация W3C WebDriver
- Документация Playwright
- Документация Playwright MCP
- Тестирование Cloudflare Turnstile
- Репозиторий CloakBrowser
- Лицензия готовой сборки CloakBrowser
- Репозиторий CloakBrowser MCP
- Архитектура CloakBrowser MCP
- Сравнение Playwright MCP и CloakBrowser MCP
- Как Cloudflare обнаруживает автоматизированный трафик
- Настройка браузера в Playwright MCP