Проект
Датасет олимпиадных математических задач
Русифицированный датасет для обучения, файнтюнинга и оценки LLM
О проекте
О проекте
О проекте
Развивать математические способности языковых моделей сложно без качественных данных. При этом в русскоязычном сегменте почти нет крупных датасетов олимпиадного уровня, которые помогают моделям учиться сложным рассуждениям, понимать математический контекст и работать с нестандартными задачами. Такие датасеты важны не только для оценки математических навыков, но и для проверки общего уровня reasoning — способности модели выстраивать логические цепочки и делать обоснованные выводы.
ЗАДАЧА
ЗАДАЧА
ЗАДАЧА
Перед командой стояла цель — создать надежный русскоязычный корпус задач AIME, сохранить точность математических формул, структуру оригинальных материалов и подготовить данные для работы с современными LLM.
РЕШЕНИЕ
РЕШЕНИЕ
РЕШЕНИЕ
Мы разработали полный пайплайн по сбору, обработке, переводу и адаптации задач American Invitational Mathematics Examination (AIME).
В качестве источника использовали архив Art of Problems Solving (AoPS), содержащий задачи соревнований с 1983 по 2025 годы. Автоматизированный Python-пайплайн собрал условия, решения, ответы и метаданные задач, сохранив математическую нотацию LaTeX и структуру исходных материалов.
Для перевода корпуса на русский язык реализовали автоматизированный процесс с использованием модели DeepSeek Reasoner через API. Специально разработанные промпты позволили сохранить математические выражения, форматирование и терминологическую точность.
На финальном этапе данные были преобразованы в машиночитаемый формат, подходящий для обучения и оценки языковых моделей: задачи были разделены на тестовый набор и few-shot примеры, дополнены метаданными, категориями и вариантами решений.
РЕЗУЛЬТАТ
РЕЗУЛЬТАТ
РЕЗУЛЬТАТ
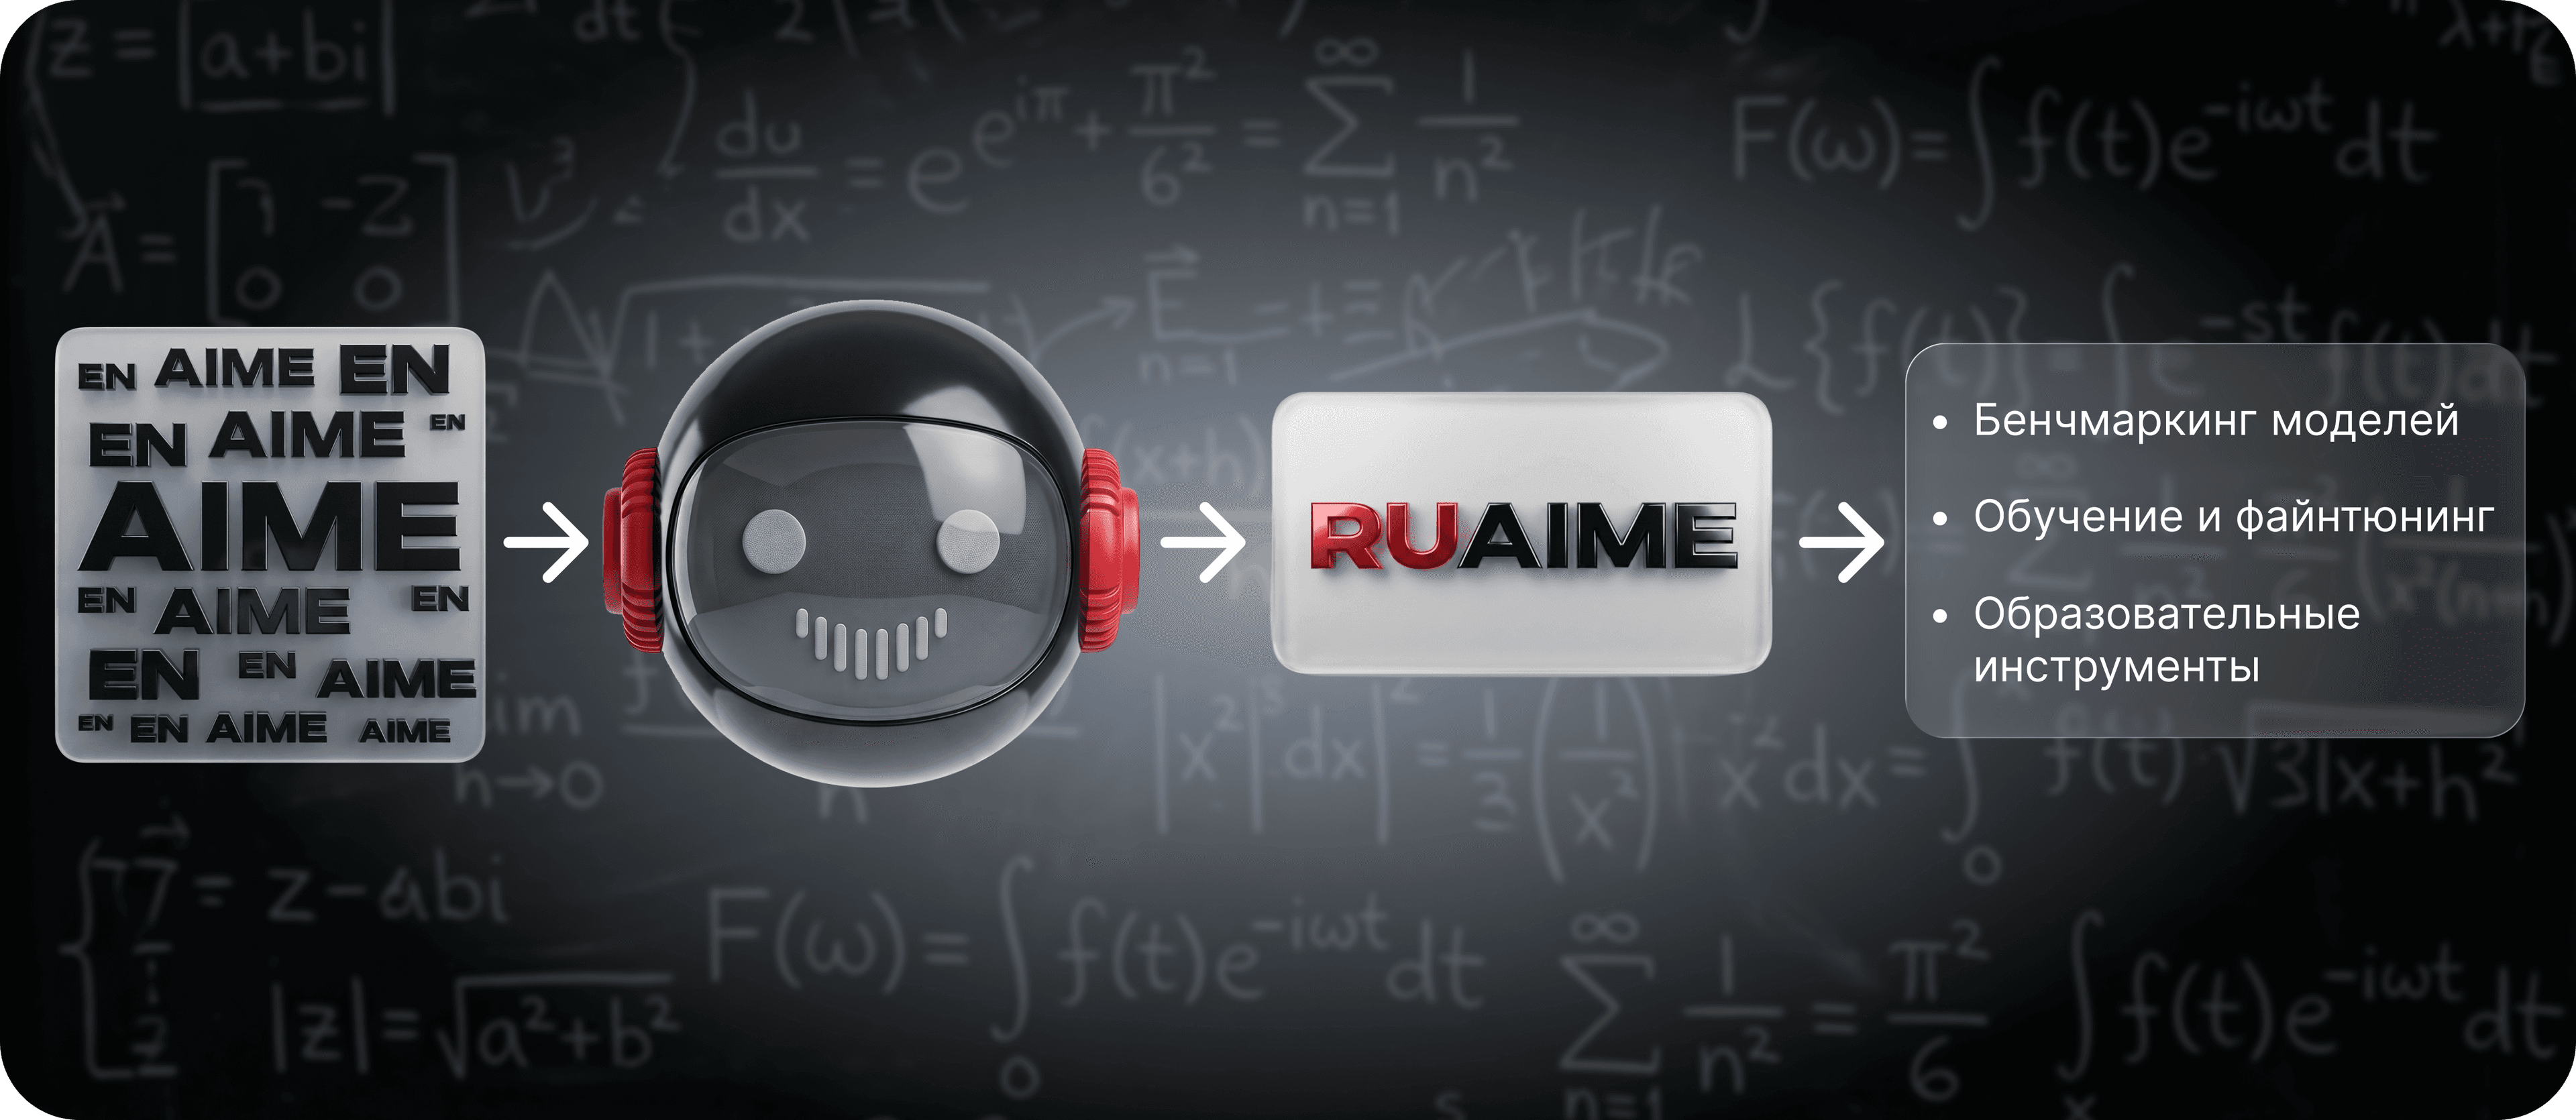
Мы создали ruAIME — русскоязычный датасет олимпиадных математических задач с оригинальными английскими версиями, переводами, решениями и метаданными.
Датасет можно использовать для:
- обучения и тонкой настройки математических языковых моделей;
- оценки способности моделей к сложным логическим рассуждениям;
- создания образовательных AI-продуктов и интеллектуальных помощников;
- проведения исследований в области кросс-лингвистического машинного обучения.
Для проверки качества датасета мы провели тестирование модели DeepSeek Reasoner через фреймворк lm-evaluation-harness. В тестах на русскоязычном наборе задач модель достигла точности около 70%, подтвердив возможность эффективного использования датасета для оценки математических возможностей современных LLM.
РЕАЛИЗАЦИЯ
РЕАЛИЗАЦИЯ
РЕАЛИЗАЦИЯ
Ключевой особенностью проекта стала разработка полностью автоматизированного пайплайна подготовки данных:парсинг и извлечение задач из веб-архива AoPS;
- обработка HTML-контента и сохранение математической разметки LaTeX;
- автоматическое извлечение ответов и решений;
- очистка данных, поиск дубликатов и контроль качества датасета;
- перевод корпуса с помощью LLM через API;
- структурирование данных в форматах Parquet и JSON;
- подготовка тестовых наборов для использования в lm-evaluation-harness.
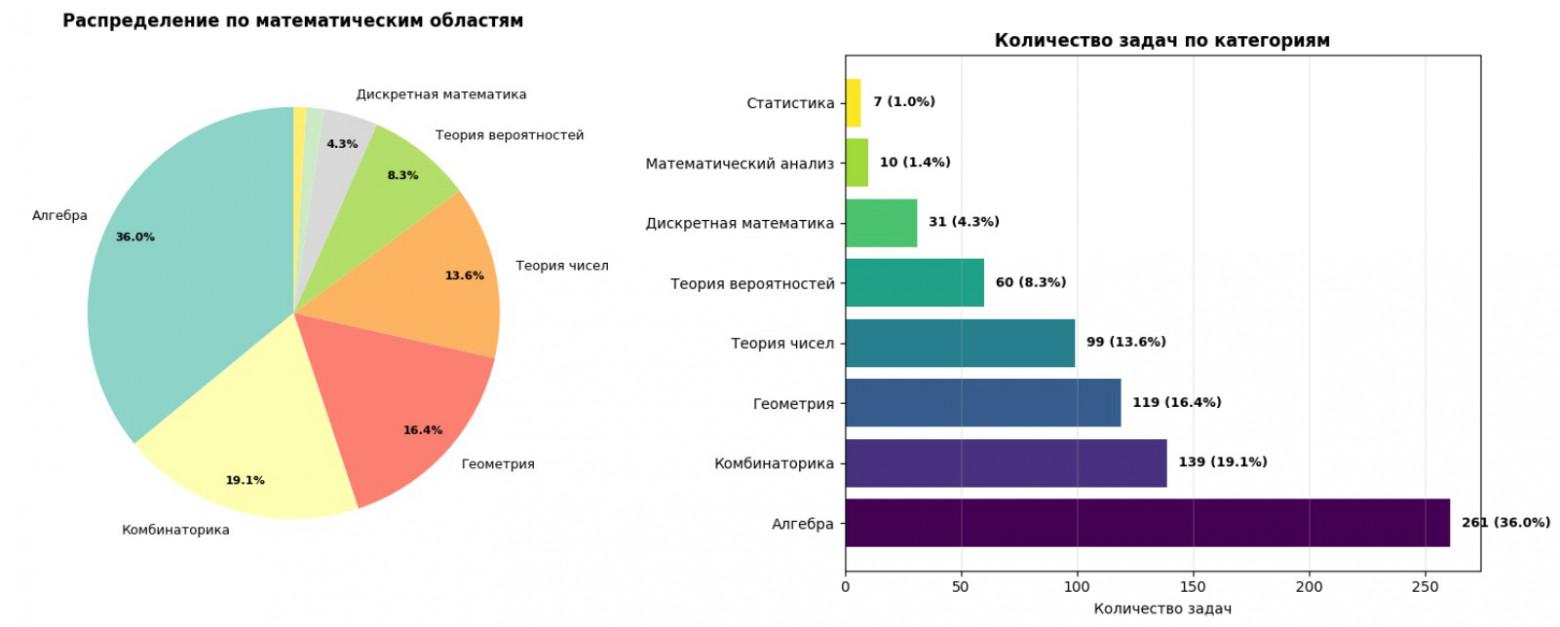
Дополнительно провели статистический анализ датасета: проверили распределение ответов, тематический баланс задач, отсутствие значимых аномалий и дубликатов. Анализ показал высокое качество и репрезентативность корпуса для задач машинного обучения.